
DeepSeek V4.1 Flash是什么
DeepSeek V4.1 Flash是DeepSeek全新模型结构系列中的最小尺寸模型,552B MoE,采用非对称Causal-Encoder-Decoder,输入激活约8B、输出16B,具备原生多模态视觉理解能力。同时模型显著压缩KV Cache以降低长上下文与Agent成本,API通过deepseek-flash调用,配合降价与峰谷计费,腾讯(WorkBuddy、CodeBuddy)和 OpenCode 作为官方合作伙伴,现已全量接入 DeepSeek V4.1 Flash,并已在Hugging Face开源。
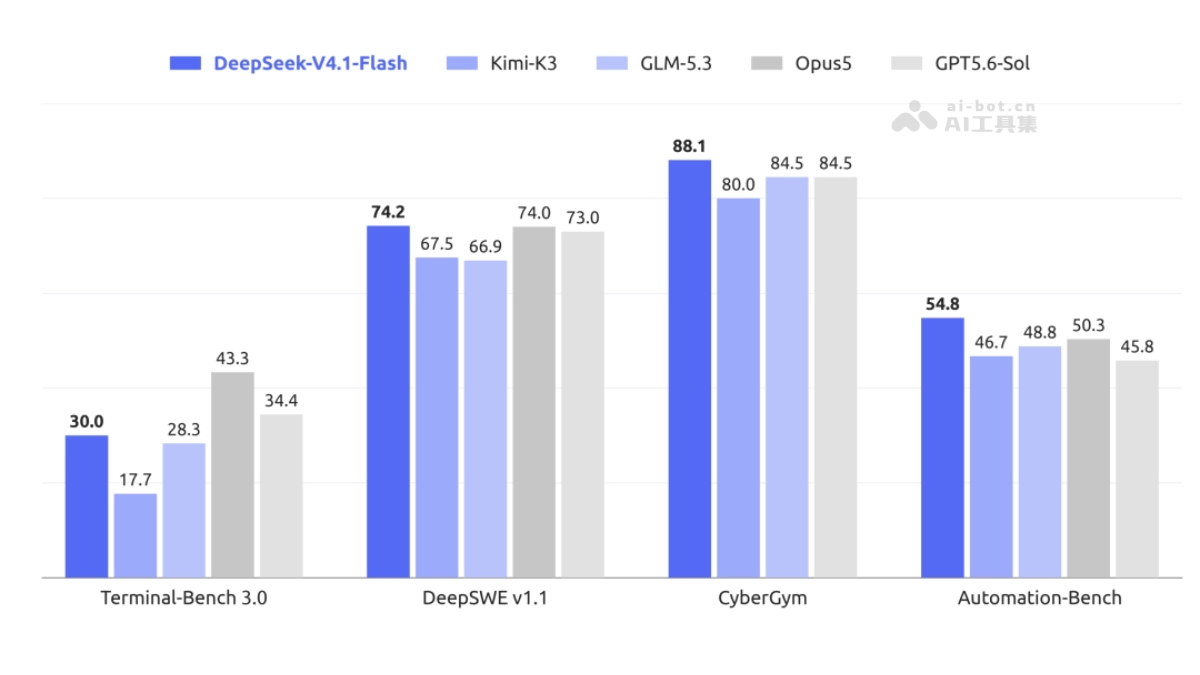
DeepSeek V4.1 Flash的主要功能
-
更强智能:552B MoE 采用新 Causal-Encoder-Decoder 结构,经更大规模强化学习后训练,基准超越 V4 Pro。
-
更快推理:输入激活仅 8B、输出激活 16B,兼顾速度与能力,吞吐更高。
-
原生多模态:具备视觉理解能力,可处理图文输入。
-
显著省缓存:KV Cache 大降,HBM 需求降至 1/4、SSD 降至 1/8,降低 Agent 成本。
DeepSeek V4.1 Flash的技术原理
-
非对称 Causal-Encoder-Decoder:核心思路是让“读入理解”和“生成输出”采用不同计算强度,输入侧激活约 8B、输出侧激活约 16B,在保证生成质量的同时压低推理成本。
-
MoE 稀疏激活:总参数 552B,但每次只激活小部分专家参数,用更高参数容量换取更强表达,同时避免全量激活带来的高延迟与高显存占用。
-
训练范式升级:采用新的预训练方式,做更大规模强化学习后训练,使其在 Agentic 基准上超过包括 V4 Pro 在内的旗舰模型。
-
KV Cache 压缩:通过降低上下文缓存占用,把对 HBM 的需求压到上一代 1/4、SSD 到 1/8;相对初代累计缩小 437 倍,直接降低长上下文与 Agent 缓存命中成本。
-
面向规模化设计:结构目标兼顾更高能力上限、更快推理、更大吞吐,可扩展到更大参数模型,因此能在 API 降价的同时仍覆盖多模态与复杂 Agent 场景。
如何使用DeepSeek V4.1 Flash
-
准备密钥:获取 DeepSeek API Key。
-
接入地址:使用 OpenAI 兼容方式,设置
base_url="https://api.deepseek.com"。 -
指定模型:调用时将
model写成deepseek-flash。 -
多模态输入:图文理解按多模态消息格式传入图片 URL 或 base64。
-
旧版兼容:
deepseek-v4-flash、deepseek-v4-flash-vision-exp会暂时路由到 V4.1 Flash。 -
Pro 切换:
deepseek-v4-pro在 2026-09-14 12:00 后路由到 V4.1 Flash 并按其计费。 -
开源部署:私有化可用 Hugging Face 权重,大规模部署需约 2k 卡 GPU、存储集群并联系官方。
DeepSeek V4.1 Flash的核心优势
-
极致速度:社区实测输出普遍 300~400 tokens/s,峰值达 507 tokens/s,交互体验接近”秒回”。
-
原生多模态:视觉能力直接融入基座架构,无需像 V4 Flash 那样依赖单独的视觉版本。
-
价格不变、隐性降价:能力升级但计费维持 V4 Flash 水平,空闲时段缓存命中输入低至 0.05 元/百万 tokens。
-
架构焕新:采用全新模型结构,是 DeepSeek 新一轮技术路线的先行版,后续升级空间更大。
-
接入零成本:base_url 不变、仅改模型名即可调用,老用户无缝切换。
DeepSeek V4.1 Flash的项目地址
- HuggingFace模型库:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- 技术论文:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
DeepSeek V4.1 Flash的同类竞品对比
| 维度 | DeepSeek V4.1 Flash | 智谱 GLM-5.3 Flash |
|---|---|---|
| 多模态 | 原生支持(架构级融合) | 支持图片、视频、文件、文本 |
| 输出价格 | 4.5元/百万tokens(空闲) | 约$0.50/百万tokens(促销期$0.25) |
| 输入价格 | 0.05~1.5元/百万tokens(空闲) | 约$0.15/百万tokens(促销期$0.075) |
| 并发限制 | 每账号20并发(内测限流) | 正常商用额度 |
| 可用性 | 9月10日过期,仅两天窗口 | 已正式发布,长期可用 |
| 开源情况 | 未开源 | GLM 系列一贯开源 |
DeepSeek V4.1 Flash的应用场景
-
实时对话助手:300+ t/s 的流式输出让聊天、客服场景几乎无等待感。
-
AI 编程辅助:代码补全、片段生成对延迟极敏感,高速输出可无缝嵌入 IDE。
-
视觉理解应用:原生多模态适合截图问答、文档图片解析、UI 审查等图文混合任务。
-
轻量 Agent 执行层:Agent 需高频串行调用模型,低成本+高吞吐适合做执行与分拣环节。
-
内容批量生产:文案改写、摘要、翻译等流水线任务,靠低单价+缓存命中把成本压到最低。