
What is UniTalker
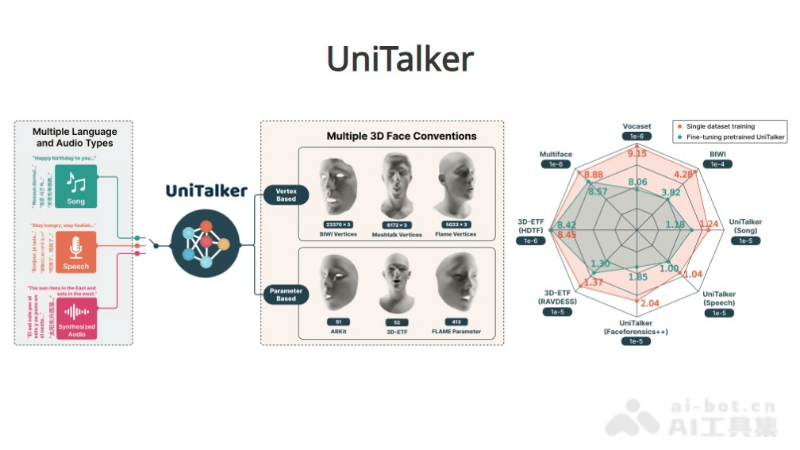
UniTalker is an audio-driven 3D facial animation generation model launched by SenseTime, capable of generating realistic facial movements based on input audio. It adopts a unified multi-head architecture model, uses datasets with different annotations, and supports processing of multiple languages and various audio types, including speech and songs. Whether it is clear human voice or slightly noisy singing, UniTalker handles it very well. UniTalker can generate facial movements for multiple characters at the same time without redesign, making it very flexible and convenient.
Main Features of UniTalker
- Audio-Driven 3D Facial Animation: UniTalker generates realistic 3D facial movements based on input audio, and the virtual character's facial expressions and lip movements can synchronize with the voice.
- Supports Multiple Languages and Multiple Audio Types: It can process speech in different languages and different types of audio files. UniTalker is especially useful in internationalized application scenarios.
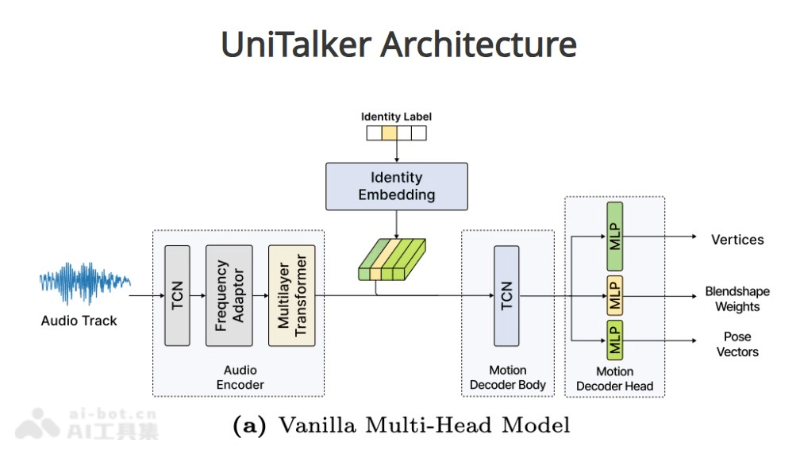
- Unified Model Architecture: UniTalker adopts a unified multi-head architecture model and can process multiple different datasets and annotation types simultaneously within one framework, improving the model's versatility and flexibility.
- Training Stability and Consistency: By adopting training strategies such as principal component analysis (PCA), model warm-up, and pivot identity embedding, UniTalker shows better stability during training and ensures consistency among multi-head outputs.
Technical Principles of UniTalker
- Multi-Head Architecture Model: UniTalker adopts a unified multi-head architecture design, trained on datasets with different annotations, to handle various 3D facial animation needs.
- Training Strategies: To improve training stability and ensure consistency among multi-head outputs, UniTalker adopts three training strategies, including principal component analysis (PCA), model warm-up, and pivot identity embedding.
- Large-Scale Datasets: The research team built A2F-Bench. The benchmark includes five publicly available datasets and three newly compiled datasets, expanding the scale and diversity of training data and covering multilingual speech and songs.
- Audio Encoder: UniTalker uses an audio encoder to convert input audio into contextualized audio features, providing the foundation for subsequent facial movement generation.
UniTalker Project Address
- Project Official Website:https://x-niper.github.io/projects/UniTalker/
- Github Repository:https://github.com/X-niper/UniTalker
- arXiv Technical Paper:https://arxiv.org/pdf/2408.00762
Application Scenarios of UniTalker
- Animation Production: UniTalker can generate realistic 3D facial movements based on input audio, creating rich expressions and lip movements for animated characters.
- Virtual Reality (VR): In virtual reality environments, UniTalker can generate corresponding facial movements based on voice commands, enhancing the immersive experience.
- Game Development: UniTalker can generate natural facial expressions and movements for non-player characters (NPCs) in games, enhancing the interactivity and realism of the game.
- Language Learning: UniTalker can generate lip movements and expressions for a specific language, helping learners imitate pronunciation and expressions and improving language learning outcomes.
- Multilingual Support: UniTalker supports audio input in multiple languages and processes multilingual speech including Chinese, making it suitable for internationalized scenarios.